本文同步收录自我在编程导航发布的同名文章;另见 CSDN 版本。正文以所链接的编程导航公开版本为准,保留该版本的原始发布日期。
本文保留原文“已做、进行中、后续补齐”的阶段划分,清单中的条目不代表全部已实现。
一、AI 应用上线最小护栏清单
如果你的 AI 应用准备上线,至少要有这张表。
| 护栏 | 必须做什么 | 不做的后果 |
|---|---|---|
| 用户级限流 | 限制单用户每分钟、每天、每月调用次数 | 被单个用户刷爆额度 |
| IP 级限流 | 限制匿名 IP 或异常 IP 请求 | 被脚本、爬虫、代理刷爆 |
| 高成本接口单独限流 | 对深度分析、PDF、长上下文接口加更严限制 | 一个按钮打穿账单 |
| AI 任务幂等 | 同一输入重复提交只生成一个任务 | 重复扣点、重复调用模型 |
| traceId | 每个请求贯穿前端、后端、AI、PDF、日志 | 出错无法定位 |
| AI 调用日志 | 记录模型、耗时、token、状态、错误码 | 无法审计和复盘 |
| 模型错误码分类 | 区分限流、超时、鉴权、内容安全、JSON 失败 | 全部变成“服务器异常” |
| JSON 解析失败兜底 | Schema 校验、修复、降级结果 | 模型输出一乱前端就崩 |
| Redis 缓存 | 对相同输入、相同 Prompt 版本复用结果 | 重复请求浪费成本 |
| 输入 hash | 不直接用原文做缓存 key | 泄露隐私、缓存不可控 |
| promptVersion | Prompt 改版后缓存自动失效 | 新旧结果混用 |
| token 成本记录 | 记录 input/output/cached token 和估算成本 | 账单不可解释 |
| 失败不乱扣点 | reserve、commit、refund 三段式扣点 | 用户信任崩塌 |
| PDF 任务队列 | 导出走异步队列,限制并发 | Puppeteer/浏览器服务被打爆 |
| 审计记录 | 记录谁在什么时候对什么数据做了什么 AI 操作 | 出问题无法追责 |
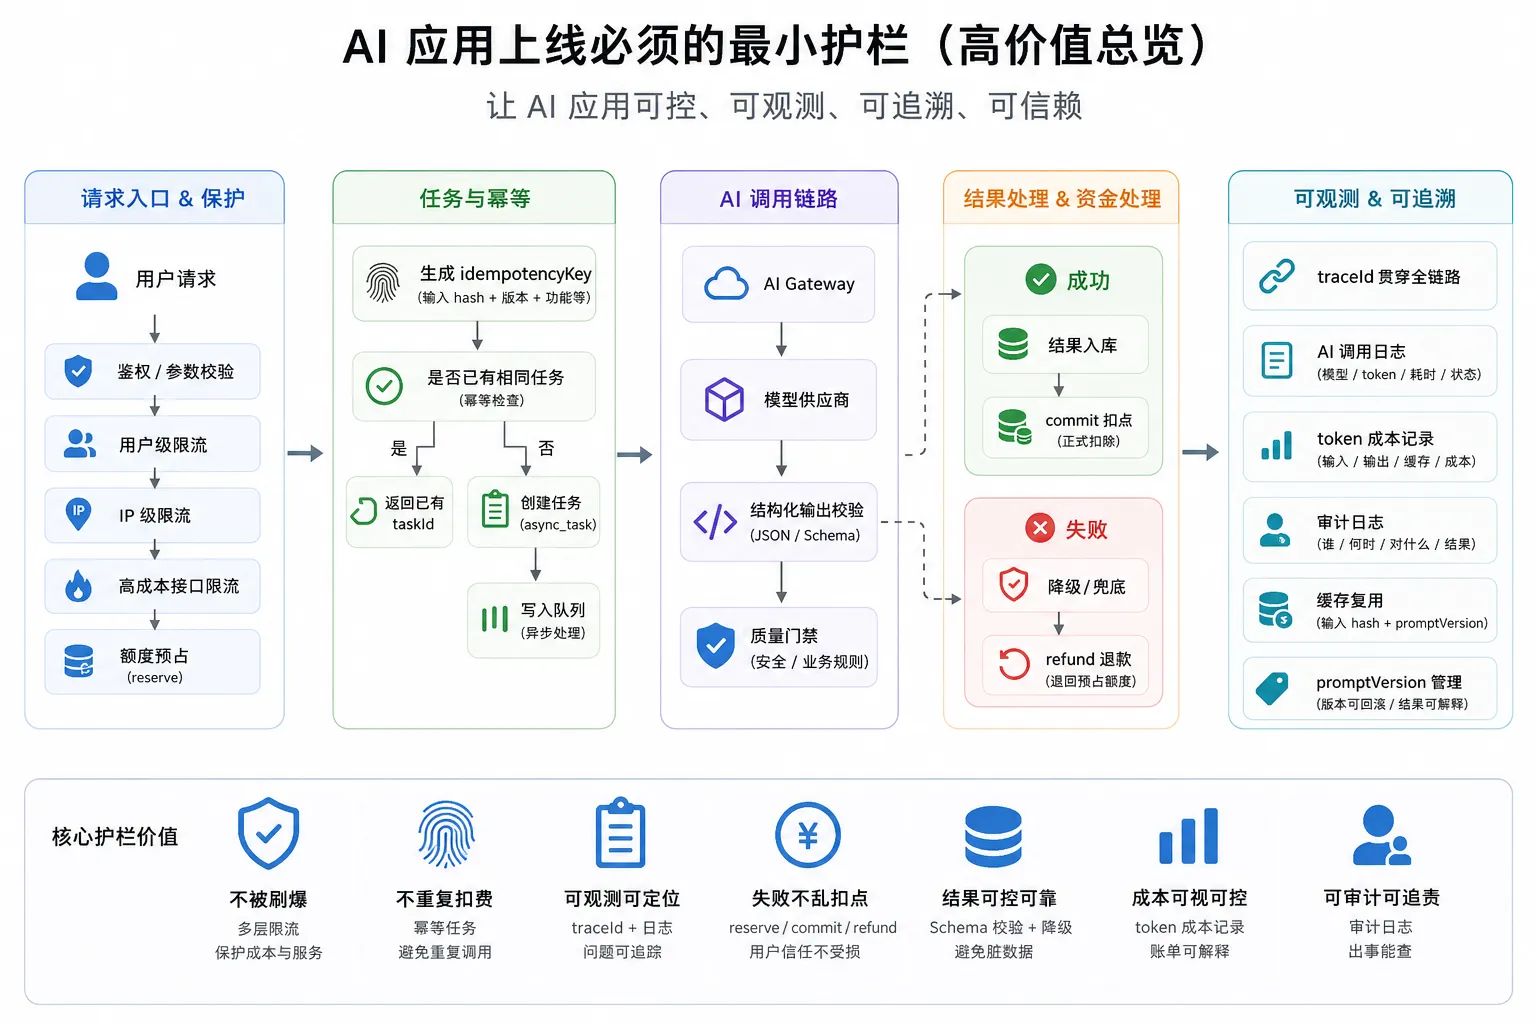
这些不是“大厂才需要”的东西。只要你接了大模型 API,只要你的产品对外开放,哪怕只有几十个内测用户,也应该做最小版本。如果把这些护栏压缩成一张图,它大概是这样的:
很多 AI 应用 Demo 看起来都很简单:用户输入一段文本,后端拼一个 Prompt,请求大模型,再把结果展示出来。
但一旦真的上线,问题会马上暴露:
- 用户连续点按钮,模型账单飙升;
- 同一个请求重复提交,扣了多次额度;
- 模型返回半截 JSON,前端直接崩;
- 第三方模型限流,用户只看到“服务器异常”;
- AI 生成失败了,系统却扣了点数;
- 管理员想查一次调用为什么失败,结果没有 traceId、没有日志、没有成本记录;
- PDF、AI、上传、分享这些高成本/高风险链路全部挤在同步接口里。
所以,AI 应用从 Demo 到可上线产品,中间真正差的不是“多接几个模型”,而是一套最小生产护栏。
为了不把这些护栏讲成散点,下面我会按一次 AI 请求的生命周期来拆:
入口阶段:先挡住异常用户、异常 IP 和高成本请求;
任务阶段:保证同一请求不会重复创建、重复调用、重复扣点;
调用阶段:通过 AI Gateway 统一记录模型、token、耗时和错误;
输出阶段:对 JSON、Schema、质量门禁和 fallback 做兜底;
追踪阶段:用 traceId、调用日志、审计日志把整条链路串起来。
也就是说,AI 应用上线不是给每个接口加几个 if,而是把一次 AI 调用当成一个可追踪、可补偿、可审计的任务。
这篇文章以我上线简喵的经验为例,拆一套 AI 应用上线后必须具备的工程护栏:限流、日志、降级、缓存、审计、成本、任务队列和失败兜底。
简喵是一个证据约束型 AI 求职助手,核心链路是:
简历模板 / 编辑
→ 目标岗位分析(JD诊断)
→ 岗位竞争力诊断
→ 投递文案
→ PDF 导出
这类项目的特点很典型:AI 调用有成本,用户输入包含隐私,模型输出必须结构化,失败不能乱扣额度,生成结果还要能追溯。
简喵项目在线体验地址:在线体验
部署上线及域名绑定全流程:****
AI功能测试见上一篇博客:****
二、总链路:不要让业务接口直接调用模型
先看整体链路。后面所有护栏,都是围绕这条链路展开的。
很多早期项目会这样写:
Controller
→ 拼 Prompt
→ 调模型
→ 返回结果
这在 Demo 阶段可以跑,但上线后非常危险。更合理的结构应该是:
用户请求
→ API Controller
→ 鉴权 / CSRF / 参数校验
→ 限流
→ 额度预占
→ 幂等任务检查
→ 异步任务队列
→ AI Gateway
→ 模型供应商
→ JSON 校验 / 降级
→ 结果入库
→ 扣点提交或退款
→ 前端轮询任务结果
可以画成这样:
flowchart TD
  A["用户提交 AI 请求"] --> B["鉴权 / 参数校验"]
  B --> C["用户级 + IP 级限流"]
  C --> D["额度预占 reserve"]
  D --> E["生成 inputHash + idempotencyKey"]
  E --> F{"是否已有相同任务"}
  F -->|有| G["返回已有 taskId"]
  F -->|无| H["写入 async_task"]
  H --> I["AI Gateway"]
  I --> J["模型供应商"]
  J --> K["结构化输出校验"]
  K -->|成功| L["结果入库 + commit 扣点"]
  K -->|失败| M["降级 / fallback + refund"]
  L --> N["审计日志"]
  M --> N
N --> O["前端轮询展示"]这里的关键点是:AI 调用不是一个普通同步接口,而是一个有成本、有状态、有失败补偿的任务。
后面按五层护栏展开:防成本失控、防重复提交、防模型输出失控、防问题无法追踪、防高成本任务拖垮服务。
三、第一层护栏:防止成本被刷爆
第一层护栏解决的是成本和滥用问题:谁能调用、多久能调用一次、哪些高成本接口必须更严格限制。
AI 应用不能只做一个全局限流。不同风险要分层。
1. 用户级限流
用户级限流解决的是“单个登录用户重复点击或恶意刷调用”。
例如:
目标岗位分析:每用户每分钟 2 次
岗位竞争力诊断:每用户每分钟 1 次
投递文案:每用户每分钟 3 次
Redis key 可以这样设计:
rate:user:{userId}:{feature}:{window}例如:
rate:user:123:job_score:202607041530如果使用滑动窗口,key 可以更细:
rate:user:{userId}:{feature}:slidingvalue 用 sorted set 存时间戳。
Redis 官方文档里也明确提到,滑动窗口比固定窗口更能平滑处理突发请求,避免固定窗口边界被打穿。
2. IP 级限流
IP 级限流解决的是匿名请求、注册接口、登录接口、验证码接口、分享访问、PDF 下载等入口被刷。
例如:
rate:ip:{clientIp}:auth_login
rate:ip:{clientIp}:pdf_export
rate:ip:{clientIp}:ai_submit
注意:如果你用了 Cloudflare / Nginx 反代,后端不能直接信任 X-Forwarded-For。必须只信任来自 Cloudflare 或受控反代的真实 IP 头,否则攻击者可以伪造 IP 绕过限流。
3. 高成本接口单独限流
AI 应用里不是所有接口成本一样。
低成本:
投递短文案
简历字段建议
标题润色
高成本:
长简历 + 长 JD 深度诊断
岗位竞争力体检
面试追问包
PDF 服务端导出
OCR / 文档解析
高成本接口应该有单独阈值:
rate:user:{userId}:heavy_ai
rate:ip:{ip}:heavy_ai
rate:global:heavy_ai
这样即使单个用户额度足够,也不能瞬间把队列打爆。
4. Redis 缓存:缓存的是“同一输入 + 同一 Prompt 版本”的结果
AI 缓存不是简单把用户问题当 key。
错误做法:
cacheKey = userInput问题:
- 泄露隐私;
- 文本太长;
- Prompt 改了以后还命中旧结果;
- 不同模型结果混用;
- 不同用户场景串污染。
正确做法:
cacheKey =
  ai:cache:{feature}:{model}:{promptVersion}:{inputHash}
其中 inputHash 可以这样算:
sha256(
  normalizedResumeVersion
  + normalizedJD
  + scenario
  + promptVersion
)
缓存值里记录:
{
  "result": {},
  "promptVersion": "job-score-v3",
  "model": "glm-5.2",
  "createdAt": "2026-07-04T12:00:00",
  "ttl": 86400
}
缓存 TTL 建议:
投递文案:几小时到 1 天
JD 诊断:1 到 7 天
岗位竞争力诊断:1 到 7 天
高风险写入类建议:短 TTL 或不缓存
重复 Prompt 前缀可以降低延迟和成本,但这是模型供应商层面的缓存;业务侧仍需要自己的结果缓存和幂等。
5. token 成本记录:AI 成本不是月底看账单才知道
AI 成本必须在每次调用时记录。
至少记录:
inputTokens
outputTokens
cachedTokens
modelName
unitPrice
estimatedCost
actualCostStatus
如果供应商返回 usage,就用供应商 usage。
如果不返回,就用本地 tokenizer 或估算逻辑,标记为 estimated。
一条成本记录可以长这样:
{
  "feature": "JOB_SCORE",
  "model": "GLM-5.2",
  "inputTokens": 6200,
  "outputTokens": 1800,
  "cachedTokens": 0,
  "estimatedCost": 0.018,
  "currency": "CNY",
  "traceId": "01JZ..."
}
如果是免费产品,也不能没有成本记录。免费不等于没有成本,只是你暂时替用户承担了成本。
这一层护栏的目标很简单:不要等到账单爆了才发现问题。限流负责挡住异常调用,缓存负责减少重复调用,token 成本记录负责解释每一次调用到底花在哪里。
四、第二层护栏:防止重复提交和乱扣点
第二层护栏解决的是任务一致性问题:同一个输入不能重复创建任务,不能重复调用模型,更不能重复扣点。
1. AI 任务幂等:同一请求不要重复扣费
这是很多 AI 产品最容易忽略的问题。
用户点击“生成岗位竞争力诊断”,如果网络慢,他可能连续点三次。没有幂等的话,后端会创建三个任务,调用三次模型,扣三次点数。
正确做法是生成一个幂等 key:
idempotencyKey =
  userId
  + feature
  + resumeVersionId
  + jobSessionId
  + inputHash
  + promptVersion
  + model
其中:
inputHash:用户输入、简历版本、JD 文本等核心输入的 hash;promptVersion:Prompt 模板版本;feature:功能名,例如JD_DIAGNOSIS、JOB_SCORE、DELIVERY_NOTE;resumeVersionId / jobSessionId:避免不同会话串结果。
示例代码:
String key = buildIdempotencyKey(userId, feature, versionId, sessionId, inputHash, promptVersion);

AiTask existing = taskRepository.findRunningOrRecentByKey(key);

if (existing != null) {
    return existing.taskId();
}

AiTask task = taskRepository.createQueuedTask(key, userId, feature);
queue.submit(task);
return task.taskId();
状态机建议至少包含:
queued
running
succeeded
failed
canceled
refunded
不要只用 success=true/false。AI 任务是长链路,状态必须可解释。
2. 失败不乱扣点:reserve、commit、refund 三段式
这是用户信任的底线。
错误做法:
用户点击按钮
→ 直接扣点
→ 模型失败
→ 用户没结果也没点数
正确做法:
1. reserve:创建任务时预占额度
2. commit:任务成功并通过质量校验后正式扣点
3. refund:任务失败、超时、JSON 不合格、质量门禁拒绝时退回
状态流:
stateDiagram-v2
  [*] --> RESERVED
  RESERVED --> COMMITTED: AI成功且结果可展示
  RESERVED --> REFUNDED: 模型失败/超时/解析失败
  RESERVED --> EXPIRED: 长时间未执行
  COMMITTED --> [*]
  REFUNDED --> [*]
  EXPIRED --> [*]
账本表建议:
CREATE TABLE ai_credit_ledger (
  id BIGINT PRIMARY KEY,
  user_id BIGINT,
  task_id BIGINT,
  feature VARCHAR(64),
  change_amount INT,
  balance_after INT,
  type VARCHAR(32), -- RESERVE / COMMIT / REFUND
  reason VARCHAR(255),
  trace_id VARCHAR(64),
  created_at DATETIME
);
用户看到的文案也要讲人话:
AI 服务暂时不可用,本次未消耗额度。不要写:
MODEL_EMPTY_OUTPUT
reserve credits failed
JSON parse error
内部错误码留给日志,不要泄漏给普通用户。
这一层护栏的目标不是提升模型效果,而是保护用户信任:网络慢、模型失败、JSON 解析失败,都不能让用户承担系统的不确定性。
五、第三层护栏:防止模型输出失控
第三层护栏解决的是模型输出不稳定问题:模型可以生成内容,但不能直接决定业务结果。所有输出都必须经过错误分类、Schema 校验、质量门禁和前端可理解的提示。
1. 模型错误码分类:不要全都叫服务器异常
模型调用失败不等于系统崩了。至少要分这些类型:
| 错误码 | 含义 | 用户提示 |
|---|---|---|
MODEL_TIMEOUT | 模型超时 | AI 服务响应较慢,请稍后重试 |
MODEL_RATE_LIMITED | 供应商限流 | 当前 AI 服务繁忙,已保留你的内容 |
MODEL_AUTH_FAILED | API Key / 鉴权失败 | 服务配置异常,请联系管理员 |
MODEL_SERVER_ERROR | 模型供应商 5xx | AI 服务暂不可用,请稍后再试 |
MODEL_CONTENT_BLOCKED | 内容安全拦截 | 当前内容无法生成,请调整输入 |
MODEL_EMPTY_OUTPUT | 返回为空 | 已生成保守兜底版本或未消耗额度 |
JSON_PARSE_FAILED | JSON 解析失败 | AI 返回格式异常,系统已降级处理 |
SCHEMA_VALIDATION_FAILED | Schema 校验失败 | 结果结构不完整,未写入最终结果 |
QUALITY_GATE_REJECTED | 质量门禁拒绝 | 本次结果未达到展示标准,未扣点或已退回 |
2. JSON 解析失败兜底:结构化输出也不能完全裸奔
AI 应用经常要求模型返回 JSON:
{
  "score": 82,
  "summary": "...",
  "risks": [],
  "fixTasks": []
}
但真实线上会遇到:
- JSON 前后带 Markdown
- 少一个右括号
- enum 返回了不存在的值
- 数组变成字符串
- 空字段过多
- 模型把解释写到 JSON 外面
如果直接 JSON.parse(),前端就会炸。
生产级做法:
模型输出
→ 提取 JSON 块
→ JSON parse
→ Schema 校验
→ 一次修复
→ 再校验
→ 失败则 fallback
如果模型支持结构化输出,优先使用 Schema 约束。但即使使用结构化输出,仍建议保留后端 Schema 校验,因为你不应该把模型输出直接写入数据库或 HTML。
伪代码:
try {
    ParsedResult result = parser.parse(rawOutput);
    validator.validate(result);
    return result;
} catch (JsonParseException e) {
    String repaired = jsonRepair.repair(rawOutput);
    ParsedResult repairedResult = parser.parse(repaired);
    validator.validate(repairedResult);
    return repairedResult;
} catch (Exception e) {
    return fallbackResult(input);
}
fallback 不是假结果,而是保守结果:
AI 返回格式异常,本次未写入高风险建议。
系统基于已有简历和 JD 生成保守提示:
1. 哪些经历可直接强调
2. 哪些要求需要补证据
3. 哪些内容不能硬写
3. Prompt Injection 和输出处理:不能相信模型,也不能相信用户输入
AI 应用不是传统后端接口。Prompt 里既有系统规则,也有用户输入,还有外部文档。模型不天然区分“指令”和“数据”。
生产上至少要做:
用户输入作为数据,不作为指令
Prompt 明确边界
模型输出必须 Schema 校验
模型输出进入 HTML 前必须净化
模型输出进入数据库前必须校验
模型输出进入命令、SQL、配置前必须禁止或人工确认
以简历/JD 场景为例,最重要的规则是:
JD 是岗位要求,不是候选人事实。
简历是候选人事实来源。
没有证据的内容只能写成缺口、建议、待补充,不能写成经历。
这就是“证据约束”。
4. 用户界面也要有护栏:别把内部错误丢给用户
后端做了很多护栏,如果前端直接展示内部错误,用户体验还是很差。
错误示例:
JSON_PARSE_FAILED
reserve credits failed
same AI task creating
model output empty
应该翻译成:
AI 服务暂时没有返回可用结果,本次未消耗额度。
当前已有相同任务正在处理中,请稍后查看结果。
当前请求较复杂,已为你保留输入内容,可以稍后重试。
用户只需要知道三件事:
发生了什么
有没有扣额度
下一步能做什么
六、第四层护栏:防止问题无法追踪
第四层护栏解决的是线上排查问题:出错时,必须知道是哪次请求、哪个用户、哪个模型、哪个 Prompt 版本、哪一步失败、有没有扣点、有没有退款。
1. traceId:所有日志必须能串起来
没有 traceId 的系统,线上问题基本靠猜。
一次 AI 调用至少跨这些层:
浏览器
→ Nginx
→ Backend API
→ Async Task
→ AI Gateway
→ Model Provider
→ JSON Parser
→ DB
→ 前端轮询
必须在入口生成 traceId:
X-Trace-Id: 01JZ... 如果前端已经传了可信 traceId,可以复用;否则后端生成。
日志中至少带:
{
  "traceId": "01JZ...",
  "userId": 123,
  "feature": "JOB_SCORE",
  "taskId": "2072...",
  "sessionId": "2072...",
  "resumeVersionId": "2072...",
  "promptVersion": "job-score-v3",
  "model": "glm-4-flash",
  "status": "FAILED",
  "errorCode": "MODEL_TIMEOUT"
}
trace 的核心定义是把一次请求拆成多个 span,并用上下文把它们关联起来。OpenTelemetry Traces
日志也应该带 trace 信息,方便从错误日志跳到调用链。OpenTelemetry Logs
2. AI 调用日志:不要只记“调用成功”
AI 调用日志不是为了好看,而是为了回答这些问题:
- 谁调用了?
- 调用了哪个功能?
- 输入多长?
- 用了哪个 Prompt 版本?
- 用了哪个模型?
- 花了多少 token?
- 成功还是失败?
- 失败原因是什么?
- 有没有扣点?
- 有没有退款?
- 结果是否写入数据库?
- 是否命中缓存?
- 是否触发降级?
建议建一张调用日志表:
CREATE TABLE ai_call_log (
  id BIGINT PRIMARY KEY,
  trace_id VARCHAR(64),
  task_id BIGINT,
  user_id BIGINT,
  feature VARCHAR(64),
  model_provider VARCHAR(64),
  model_name VARCHAR(128),
  prompt_version VARCHAR(64),
  input_hash VARCHAR(128),
  request_tokens INT,
  response_tokens INT,
  cached_tokens INT,
  estimated_cost DECIMAL(10, 6),
  status VARCHAR(32),
  error_code VARCHAR(64),
  latency_ms BIGINT,
  cache_hit BOOLEAN,
  created_at DATETIME
);注意:不要把完整简历、JD、身份证、手机号、邮箱原文直接写进日志。
日志应该存 hash、长度、版本、状态、错误码。真正的用户内容要有更严格的权限和保留策略。
3. promptVersion:没有版本号,缓存和审计都会失真
Prompt 是 AI 应用里的业务逻辑。改 Prompt 就等于改规则。
所以每个功能都应该有版本号:
jd-diagnosis-v1
jd-diagnosis-v2
job-score-v3
delivery-note-v4
日志、缓存、任务、结果都要带 promptVersion。
为什么?
方便回滚
如果新 Prompt 质量变差,可以快速定位:
job-score-v4 之后投诉增加避免缓存污染
Prompt 改了,旧缓存不能继续命中。
cacheKey = feature + inputHash + promptVersion方便解释结果
用户问:“为什么这次结果和上次不一样?”
至少能回答:
模型版本不同 / Prompt 版本不同 / 输入版本不同4. 审计记录:不是为了“企业级”,是为了出事能查
AI 应用的审计至少覆盖这些动作:
用户提交 AI 请求
模型调用开始
模型调用结束
结果解析
质量门禁
额度扣减 / 退款
结果写入数据库
PDF 导出
分享链接创建
管理员查看
审计记录建议包含:
{
  "actorUserId": 123,
  "action": "AI_JOB_SCORE_CREATE",
  "targetType": "JOB_SESSION",
  "targetId": "2072...",
  "traceId": "01JZ...",
  "ip": "masked",
  "userAgent": "masked",
  "result": "SUCCEEDED",
  "createdAt": "2026-07-04T12:00:00"
}
注意两点:
1. 审计日志不等于业务日志
业务日志偏调试:
模型耗时、错误栈、状态流审计日志偏追责:
谁对什么资源做了什么操作,结果如何2. 审计日志不能存太多敏感内容
不要把完整简历、JD、Prompt 原文都塞进审计日志。
应该存资源 ID、hash、版本号、traceId。
七、第五层护栏:防止高成本任务拖垮服务
第五层护栏解决的是非模型资源问题。AI 应用里的高成本任务不只有模型调用,PDF、OCR、图片生成、文档解析这些任务也会吃 CPU、内存、浏览器进程和队列资源。
1. PDF 任务队列:PDF 导出不是普通下载接口
如果你的产品有 PDF 导出,尤其是服务端 Puppeteer/Chromium 渲染,必须做队列。
因为 PDF 导出会吃:
- CPU
- 内存
- 浏览器进程
- 字体渲染
- 页面截图/分页
- 文件写入
不能让用户直接同步打 Puppeteer。
推荐结构:
用户点击导出
→ 创建 pdf_task
→ 入队
→ worker 拉取
→ Puppeteer 渲染
→ 写文件
→ 更新状态
→ 用户轮询下载
PDF 任务状态:
queued
rendering
succeeded
failed
expired
并发限制:
PDF_TASK_QUEUE_LIMIT=8
PUPPETEER_MAX_CONCURRENT=1
PUPPETEER_MAX_QUEUE_SIZE=8
单机小服务器建议从 1 个 Puppeteer 并发开始。不要一上来开 5 个。
还要做三层限制:
用户级:每用户每分钟最多 N 次导出
IP 级:每 IP 每分钟最多 N 次导出
全局级:Puppeteer 同时最多 N 个渲染
失败兜底:
服务端 PDF 导出失败
→ 返回 taskId + 错误摘要
→ 前端提示用户
→ 提供浏览器打印/导出兜底
不要让用户只看到:
服务器异常八、最小数据库设计参考
如果把上面的护栏落到数据库,一个够用的 AI 任务系统,可以从这几张表开始:
async_task              -- AI 异步任务表,记录一次 AI/PDF 等任务的生命周期
ai_call_log             -- AI 调用日志表,记录模型调用、耗时、token、错误码等信息
ai_credit_ledger        -- AI 额度账本表,记录 reserve / commit / refund 等扣点流水
ai_prompt_version       -- Prompt 版本表,记录每个功能使用的 Prompt 版本
ai_result_snapshot      -- AI 结果快照表,保存一次任务生成后的结构化结果
audit_log               -- 审计日志表,记录谁在什么时候对什么资源做了什么操作
async_task
id                       -- 任务主键 ID
user_id                  -- 发起任务的用户 ID
feature                  -- 功能类型,例如 JD_DIAGNOSIS、JOB_SCORE、DELIVERY_NOTE、PDF_EXPORT
idempotency_key          -- 幂等 key,用来避免同一输入重复创建任务
status                   -- 任务状态,例如 queued、running、succeeded、failed、canceled、refunded
progress                 -- 任务进度,例如 0 到 100,方便前端展示处理进度
trace_id                 -- 链路追踪 ID,用来串联前端、后端、AI 调用、日志和审计记录
error_code               -- 错误码,例如 MODEL_TIMEOUT、JSON_PARSE_FAILED、PDF_RENDER_FAILED
error_message            -- 错误摘要,记录可排查的失败原因,不建议存敏感原文
created_at               -- 任务创建时间
updated_at               -- 任务最后更新时间
ai_call_log
id                       -- AI 调用日志主键 ID
task_id                  -- 关联的 async_task 任务 ID
trace_id                 -- 链路追踪 ID,用来和任务、额度账本、审计日志串联
provider                 -- 模型供应商,例如 OpenAI、DeepSeek、智谱、通义等
model                    -- 实际调用的模型名称
prompt_version           -- 本次调用使用的 Prompt 版本
input_hash               -- 输入内容 hash,用来标识相同输入,避免直接记录简历、JD 等敏感原文
request_tokens           -- 输入 token 数
response_tokens          -- 输出 token 数
estimated_cost           -- 本次调用的估算成本
status                   -- 调用状态,例如 succeeded、failed、fallback、cached
error_code               -- 调用失败时的错误码,例如 MODEL_RATE_LIMITED、MODEL_TIMEOUT
latency_ms               -- 模型调用耗时,单位毫秒
ai_credit_ledger
id                       -- 额度流水主键 ID
user_id                  -- 用户 ID
task_id                  -- 关联的 async_task 任务 ID
feature                  -- 消耗额度的功能类型
type                     -- 流水类型,例如 RESERVE、COMMIT、REFUND
change_amount            -- 额度变化数量,预占/扣减通常为负数,退款通常为正数
balance_after            -- 本次流水发生后的用户额度余额
reason                   -- 额度变化原因,例如 AI 任务成功、模型超时退款、JSON 解析失败退款
trace_id                 -- 链路追踪 ID,用来和任务、AI 调用日志、审计日志串联
ai_prompt_version
id                       -- Prompt 版本主键 ID
feature                  -- 功能类型,例如 JD_DIAGNOSIS、JOB_SCORE、DELIVERY_NOTE
prompt_version           -- Prompt 版本号,例如 job-score-v3、delivery-note-v4
model                    -- 默认绑定或推荐使用的模型
status                   -- 版本状态,例如 active、deprecated、testing
description              -- 版本说明,例如本次 Prompt 改动解决了什么问题
created_at               -- 版本创建时间
updated_at               -- 版本最后更新时间
ai_result_snapshot
id                       -- 结果快照主键 ID
task_id                  -- 关联的 async_task 任务 ID
user_id                  -- 用户 ID
feature                  -- 功能类型
prompt_version           -- 生成该结果时使用的 Prompt 版本
model                    -- 生成该结果时使用的模型
input_hash               -- 输入内容 hash,用来标识结果对应的输入版本
result_json              -- 结构化结果 JSON,例如评分、风险、建议、修复任务等
status                   -- 结果状态,例如 valid、fallback、rejected
created_at               -- 结果生成时间
audit_log
id                       -- 审计日志主键 ID
actor_user_id            -- 操作者用户 ID,例如普通用户或管理员
action                   -- 操作类型,例如 AI_JOB_SCORE_CREATE、PDF_EXPORT、ADMIN_VIEW_RESULT
target_type              -- 被操作资源类型,例如 JOB_SESSION、RESUME_VERSION、AI_TASK、PDF_TASK
target_id                -- 被操作资源 ID
trace_id                 -- 链路追踪 ID,用来追踪这次操作关联的完整链路
result                   -- 操作结果,例如 SUCCEEDED、FAILED、DENIED
created_at               -- 审计记录创建时间
这套表不复杂,但足够支撑上线后的定位、退款、审计和成本复盘。
九、上线验收:不是能跑就算完成
AI 应用上线前,我建议至少跑这些场景:
限流
同一用户连续点击 10 次
同一 IP 连续请求 50 次
高成本接口并发请求
验收:
不会重复调用模型
不会重复扣点
用户看到明确提示
幂等
同一简历 + 同一 JD + 同一功能重复提交验收:
返回同一个 taskId 或接管已有任务JSON 失败
模拟模型返回:
- 半截 JSON
- Markdown 包裹 JSON
- 缺字段
- enum 错误
验收:
系统降级,不崩溃,不写入危险结果成本
跑 10 次不同功能验收:
能看到 token、模型、功能、估算成本、是否命中缓存额度
成功
失败
超时
质量门禁拒绝
验收:
成功才 commit
失败 refund
账本可解释并发导出
长简历导出
Puppeteer 超时验收:
队列可控
失败可查 taskId
前端有兜底
十、我认为 AI 应用最小生产标准是什么?
如果只能保留 10 条,我会选这些:
1. 用户级限流
2. IP 级限流
3. 高成本接口单独限流
4. AI 任务幂等
5. traceId
6. AI 调用日志
7. JSON Schema 校验
8. 失败退款
9. token 成本记录
10. 审计日志
如果你的应用有 PDF、图片生成、OCR、RAG、Agent,再额外加:
PDF / 图片 / OCR 队列
外部 URL 白名单
工具权限边界
RAG 引用校验
Agent 操作确认
十一、简喵里我实际做了哪些最小护栏?
已做:
用户级限流 / Redis 缓存 / inputHash / promptVersion / AI 调用日志 / 失败不乱扣点 / PDF 导出限制 / traceId进行中:
更细粒度错误码 / 后台审计面板 / 成本看板 / PDF 异步队列优化后续补齐:
OpenTelemetry trace / 更完整的模型降级策略 / 管理员审计查询 / 高成本接口全局熔断十二、结尾:AI 应用上线,拼的不是“接了哪个模型”
模型 API 越来越容易接。真正难的是:
怎么限制成本
怎么处理失败
怎么保证输出可控
怎么让用户信任
怎么让出事时能追踪
怎么让免费能力不被滥用
一个能上线的 AI 应用,不应该只是:
Prompt + API Key + 前端展示而应该至少有:
限流
幂等
队列
日志
缓存
降级
审计
成本
权限
兜底
这些东西看起来不酷,但决定了产品能不能真的给用户用。
Demo 阶段可以靠一次成功截图。
生产阶段必须靠失败时也不崩的系统设计。
参考资料
- OWASP Top 10 for Large Language Model Applications
- OpenAI Production Best Practices
- OpenAI Rate Limits
- OpenAI Error Codes
- OpenAI Structured Outputs
- OpenAI Prompt Caching
- OpenAI API Pricing
- Redis Rate Limiting Patterns
- OpenTelemetry Traces
- OpenTelemetry Logs
我是 Ryan,一个专注于可信 AI 应用工程的开发者,我的个人技术博客,相比让 AI 生成更多内容,我更关心它的回答是否有证据,过程是否可追溯,结果是否经得起验证。